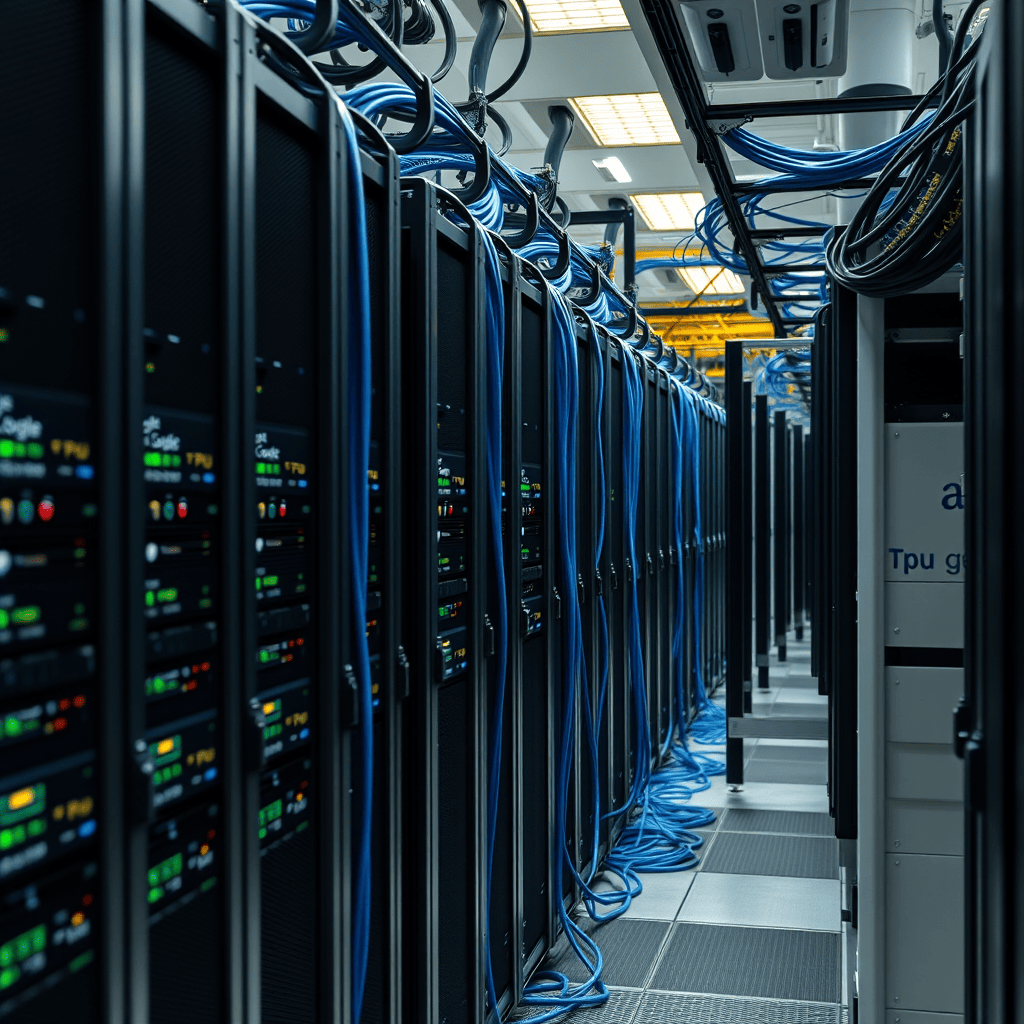
Google 正積極將其自研的張量處理單元(TPU)推向商用市場,直接挑戰輝達(NVIDIA)在 AI 硬體市場的領導地位。這家科技巨頭已將 TPU 作為其 AI 超級電腦的核心元件,並通過與博通(Broadcom)的合作,擴展至為外部客戶提供完整的 AI 基礎設施解決方案。
TPU 的商業化轉變
Google 的 TPU 已成為其 AI 超級電腦的核心元件,透過與博通的合作,TPU 業務已擴展至為 Anthropic 等外部客戶提供完整的 AI 基礎設施解決方案。根據報導,Google 自研 TPU 處理 AI 工作負載的成本比競爭對手的處理器低 30%,這一優勢在規模化部署中尤為顯著。
Google 的 TPU 簡直是為了大規模語言模型訓練而生。Anthropic 已經與 Google 簽署協議,將部署多達 100 萬顆第七代 TPU,用於訓練其 Claude 模型。這標誌著 Google 首次以直接硬體供應商的身份與輝達競爭,展現其 TPU 戰略的根本性轉變。
TPU 的技術演進與博通的角色
自 2016 年 Google 首次在 I/O 大會上公布第一代 TPU 以來,這一產品線已經歷了多次重大反覆運算。TPU 從最初僅能執行推論任務的 ASIC 晶片,演進到如今具備超強浮點運算能力、專為大規模語言模型訓練設計的超級叢集。
在這一技術演進的背後,博通扮演了極為關鍵的角色。Google 負責底層架構設計與演算法優化,而博通則協助進行 ASIC 的設計整合、高頻寬記憶體(HBM)的封裝調試以及超高速光學元件的整合,確保 TPU 叢集在大規模資料交換時不會產生頻寬瓶頸。
系統成本與生態系統的拉鋸戰
儘管輝達的 GPU 憑藉 CUDA 生態在開發者群體中擁有不可撼動的黏著度,但其昂貴的單片售價以及供應緊張引發的變動,讓許多需要大規模算力的巨頭苦不堪言。Google 的 TPU 戰略正是瞄準了這一痛點。
Google 通過將 TPU 與 Google Cloud 服務深度綁定,為客戶提供免去高昂前期硬體採購成本的「算力訂閱」模式。此外,Google 主導開發的 OpenXLA 框架正試圖打破 CUDA 的壟斷,讓開發者能夠在不大幅修改程式碼的前提下,將工作負載無縫遷移至 TPU 平台。
從產業面來看,Google TPU 的商業化轉向,是 AI 算力市場走向多元化的必然結果。長期以來,輝達的顯示記憶體與 GPU 產能瓶頸限制了整個 AI 產業的演進速度。Google 選擇在此時將第八代 TPU 推向外部市場,並與 Anthropic 等頂尖 AI 研發商深度綁定,這在戰略上是一著妙棋。
系統成本與生態系統的拉鋸戰,將成為未來 AI 晶片市場的主旋律。Google 的 TPU 提供了更具成本效益的規模化訓練方案,有望推動 AI 應用更快落地。
展望未來,Google TPU 的外部銷售戰略已被視為輝達 GPU 在 AI 晶片市場主導地位面臨的最具結構性威脅。分析師預測,到 2027 年,Google TPU 的年產量可達 500 萬塊。這場晶片大戰的關鍵不在於誰的單卡算力最強,而在於誰能提供最穩定、最具成本效益的規模化訓練方案。
對企業而言,TPU 提供了一種新的選擇,能夠在降低成本的同時,獲得高效的 AI 算力。這將有助於更多企業加速 AI 技術的應用,推動產業的創新與發展。
本文改寫整理自公開新聞來源,原始報導由T客邦發布。
常見問題 FAQ
Google TPU 是什麼?
Google TPU(張量處理單元)是 Google 自研的專用晶片,專為加速 AI 計算而設計,特別適合大規模語言模型訓練和推論任務。
TPU 與輝達 GPU 有何不同?
TPU 與輝達 GPU 的主要差異在於 TPU 專為 AI 計算設計,成本更低且系統優勢更明顯;而輝達 GPU 則憑藉 CUDA 生態在開發者群體中有更高的黏著度。
Google TPU 的商業化策略是什麼?
Google 的 TPU 商業化策略是將 TPU 與 Google Cloud 服務深度綁定,提供「算力訂閱」模式,幫助企業降低前期硬體採購成本,並提供高效、穩定的 AI 算力。
※ 此篇文章由 AI 改寫或生成,內容僅供參考,可能存在錯誤或不準確之處。
About the Author
