一個數字,足以讓所有對AI充滿憧憬的企業主與決策者,心頭一涼:高達 50% 的生成式 AI 專案,在概念驗證(PoC)階段就宣告中止。這不是什麼遙遠國度的故事,而是全球企業在擁抱 AI 浪潮時,真真切切碰到的巨大礁石。
當我們看著各行各業爭相導入 AI、談論著算力與模型如何顛覆未來時,這冰冷的數據卻像一記警鐘,敲醒了許多人。台灣,作為科技島嶼,自然也不會置身事外。那麼,這場席捲全球的 AI 落地困境,究竟出了什麼問題?
表象:AI熱潮下的隱憂
說真的,誰不希望自己的企業能搭上 AI 的順風車,提升效率、創造新價值?根據 McKinsey 的調查,全球已有 88% 的組織投入 AI 應用,這數字聽起來多麼振奮人心。然而,報告也殘酷地指出,最終能成功推進至大規模營運階段的,卻僅約三分之一。
這就好像大家都在起跑線上摩拳擦掌,但跑到一半,卻有一半的選手因為各種原因,不得不停下腳步。Gartner 的研究更是直接點名生成式 AI,指出高達一半的專案連 PoC 都過不了關。這背後的原因,不外乎是資料品質不足、風險控管不完善,以及導入成本攀升。乍看之下,這只是技術或成本問題,但如果我們再往深一層探究,會發現核心癥結點遠比想像中複雜。
可帶走的知識點: AI 導入熱潮與實際應用落地的比例存在巨大落差,尤其生成式 AI 專案在 PoC 階段的失敗率高達五成。
真相:被忽略的「資料」基石
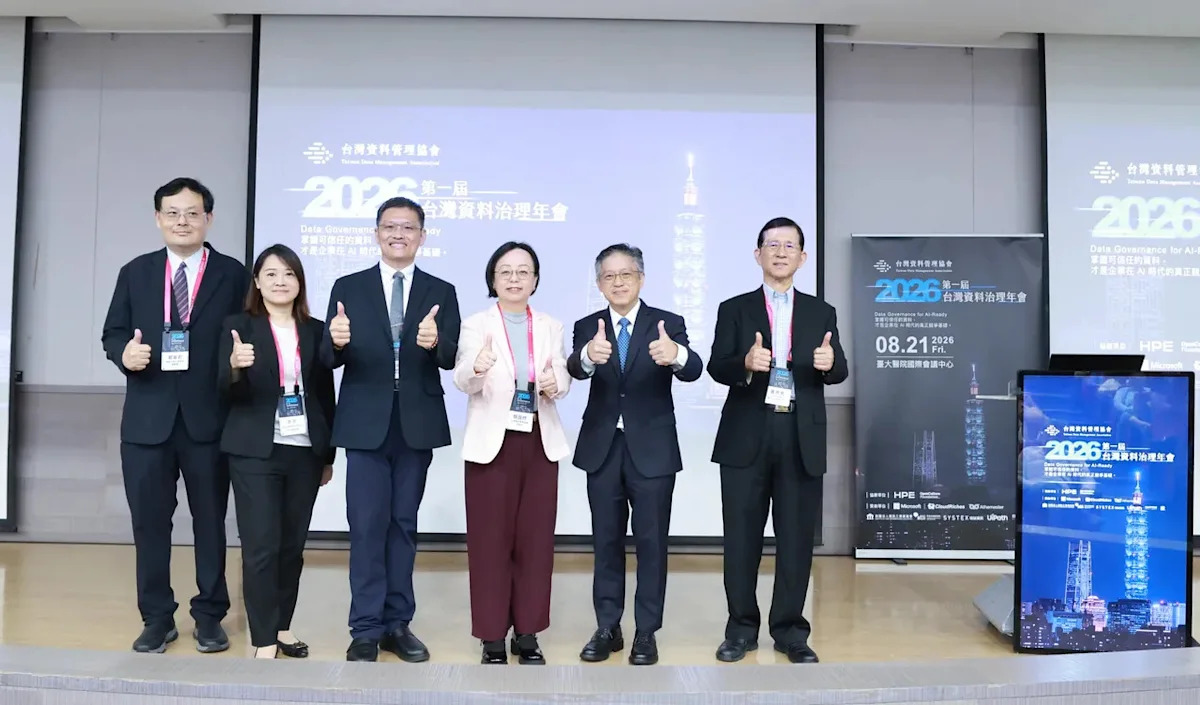
台灣資料管理協會(TDAMA)在 11 月 21 日舉辦的首屆「台灣資料治理年會」上,把這個「不能說的秘密」攤開來講。協會理事長顏良修一針見血地指出:「資料品質往往最容易被忽略,卻直接影響 AI 成效。」這句話,道出了多少企業在 AI 之路上跌跤的痛點。
試想,如果 AI 模型是頂級跑車,那資料就是它所需要的燃油。就算你開著法拉利,加了劣質汽油,它能跑多快?Cisco 的研究更顯示,有 65% 的組織難以取得高品質資料,甚至有 70% 的企業在訓練 AI 時面臨專有資料外洩風險。當企業的資料來源分散、格式不一致,或是缺乏妥善的權限與用途管理時,即便你砸大錢導入最先進的模型,也難以穩定推進到實際應用。這時候,再好的模型也只是空殼。
顏良修理事長強調:
AI 的下一階段競爭,關鍵已不再只是模型競賽,更取決於組織能否建立合身的資料結構與資料治理紀律。
這句話點破了許多人對 AI 的迷思,以為只要有強大的模型和算力就能搞定一切,卻忘了最基礎的「資料」才是真正的核心。
可帶走的知識點: 資料品質是 AI 專案成功的關鍵,遠比模型或算力更重要,缺乏完善的資料治理將導致 AI 應用難以落地。
編輯觀點: 從產業面來看,AI 發展至今,我們經歷了從「算力軍備競賽」到「模型大戰」的階段。現在,顯然已經進入了「資料品質與治理」的深水區。這對臺灣企業來說,既是挑戰也是轉機。過去許多企業在數位轉型時,往往只看到表面應用,卻忽略了底層資料的盤點與整合。現在,AI 強迫我們正視這個問題。如果臺灣能藉此機會,徹底建立起一套高品質、可信任的資料生態系,那麼我們的「主權 AI」發展,將有更穩固的根基,甚至能在全球 AI 供應鏈中,扮演更獨特的角色。畢竟,資料的「純度」,才是決定 AI「智慧」的真正上限。
各方角力:共築AI-Ready生態系
面對這樣的挑戰,台灣的政府、產業與學術界也意識到問題的嚴重性,開始積極尋求解方。數位發展部資料創新司司長王復中在年會上表示,AI 時代的國家競爭力,除了算力、人才,也需要高品質、可信任的資料。政府將持續促進安全、開放、可共享的資料生態,讓資料成為推動主權 AI、公共治理及產業創新的基礎。
這不只是一句口號,更是對未來國家發展的願景。與會專家也提出,生成式 AI 仍可能產生錯誤資訊及「幻覺」,公部門尤其應從資料源頭強化標準化、結構化及跨部門協作,並釐清資料來源、使用邊界與責任歸屬。如何在資料共享、創新應用、安全合規及個人隱私間取得平衡,無疑是一場艱鉅的挑戰,需要各方不斷磨合與努力。
為了具體推動資料治理,台灣資料管理協會也宣布了兩項重要行動:
- 將加強本土資料管理人才培育,目標兩年內推動台灣 CDMP(國際資料管理專業認證)持證人數突破 100 人。
- 今年將與中技社展開合作,針對政府、企業及學界跨域資料治理議題進行研究,進一步建立可信任、安全且具決策價值的 AI-Ready 資料生態系。
這些舉措,都指向同一個目標:為台灣的 AI 發展,打下最堅實的「資料」地基。
可帶走的知識點: 建立高品質、可信任的資料生態系,是國家級 AI 競爭力的核心,需要政府政策引導、跨部門協作與人才培育等多方努力。
深層影響:不只技術,更是信任
當我們談論 AI,往往只看到它光鮮亮麗的應用,卻忽略了背後龐大的資料基礎建設。資料品質不足,不僅會讓 AI 專案停擺,更會侵蝕企業與社會對 AI 的信任。一個不斷產生「幻覺」或錯誤資訊的 AI,其價值將大打折扣,甚至可能帶來負面影響。
從長遠來看,資料治理不僅是技術問題,更是一種管理哲學與組織文化。它要求企業重新審視資料從收集、儲存、處理到應用的全生命週期,確保其合規、安全與品質。對於台灣這樣以科技為核心的國家來說,能否在資料治理上取得領先,將直接影響我們在全球 AI 產業鏈中的地位,以及我們能否真正建立起一個「AI-Ready」的智慧社會。
可帶走的知識點: 缺乏良好的資料治理將損害 AI 的可靠性與信任度,其影響不只停留在技術層面,更會衝擊企業文化與國家競爭力。
未解之問:誰來為AI的「數據之魂」負責?
AI 的未來,繫於資料。當半數專案都在 PoC 階段卡關,我們不禁要問:誰該為這些「半途而廢」的 AI 專案負責?是技術供應商的模型不夠好?還是企業自身對資料的輕忽?
這場關於資料治理的年會,無疑為台灣的 AI 發展敲響了警鐘,也指明了方向。然而,從概念到實踐,還有漫漫長路。我們能否真正將「資料治理」內化為企業 DNA,而非僅僅是 compliance 的負擔?政府、企業、學界又該如何更緊密地協作,才能讓那些珍貴的資料,不再只是散落各處的數位孤島,而是真正能驅動 AI 智慧的「數據之魂」?
或許,是時候讓每個企業主、每個政策制定者,甚至每個資料使用者,都停下來好好思考:你的 AI,真的準備好了嗎?
本文改寫整理自公開新聞來源,原始報導由Yahoo奇摩新聞發布。
常見問題 FAQ
生成式 AI 專案在 PoC 階段失敗的主要原因是什麼?
根據 Gartner 研究,高達 50% 的生成式 AI 專案在概念驗證(PoC)階段中止,主要原因包括資料品質不足、風險控管不完善以及導入成本攀升。
為什麼資料品質對 AI 專案如此重要?
資料品質是 AI 成效的基石。台灣資料管理協會理事長顏良修指出,資料品質直接影響 AI 效能;若資料來源分散、格式不一致或缺乏權限管理,即使模型先進也難以穩定應用。
台灣政府如何應對 AI 時代的資料治理挑戰?
數位發展部資料創新司司長王復中表示,政府將持續促進安全、開放、可共享的資料生態,並從資料源頭強化標準化、結構化及跨部門協作,以平衡資料共享、創新應用、安全合規與個人隱私。
※ 此篇文章由 AI 改寫或生成,內容僅供參考,可能存在錯誤或不準確之處。
About the Author
